20. Oktober 2026 · Jan Hoppe
Content-Repository statt CMS: Wie ein KI-Agent Inhalte, Tonalität und SEO zusammenhält
Ein CMS verwaltet Seiten. Ein Content-Repository verwaltet das Wissen über Eure Inhalte – Tonalität, Zielgruppen, Keywords, Fakten – und ein KI-Agent arbeitet damit. Wie das bei produktkraft.com aussieht: von Änderungen über alle Seiten bis zum Podcast-Workflow, mit zwei Seed-Prompts zum Nachbauen.
Am Ende des Artikels über die Website-Baukasten-Alternative habe ich behauptet, der eigentliche Grund, nicht zum Baukasten zurückzuwollen, sei gar nicht die Technik. Sondern dass sich eine Änderung über alle Seiten hinweg in einem einzigen, prüfbaren Commit erledigen lässt. Diese Behauptung löse ich jetzt ein.
Denn der Stack aus statischer Seite, Cloudflare Pages und KI-Agent ist nur die eine Hälfte. Die andere ist das, was darin liegt: die Inhalte – und alles, was man über sie wissen muss, um sie gut zu schreiben. Ein CMS verwaltet Seiten. Was ich Euch hier beschreibe, verwaltet das Wissen über Eure Inhalte: wie Ihr klingt, für wen Ihr schreibt, auf welches Keyword welche Seite zielt, welche Aussagen über Euch belegt sind und welche nicht. Ich nenne das schlicht Content-Repository. Content Management ohne CMS, wenn man so will.
Content Management ohne CMS: Was in einem Content-Repository liegt
Neu ist die Idee nicht. Technische RedakteurInnen nennen sie seit Jahren Docs as Code: Dokumentation wird mit denselben Werkzeugen geschrieben wie Code – Git, Textdateien, Reviews, automatische Prüfungen. Neu ist, dass ein KI-Agent darin mitarbeitet. Und damit lohnt sich das Prinzip plötzlich nicht mehr nur für Entwicklerdokumentation, sondern für jede Website, jeden Blog, jeden Podcast.
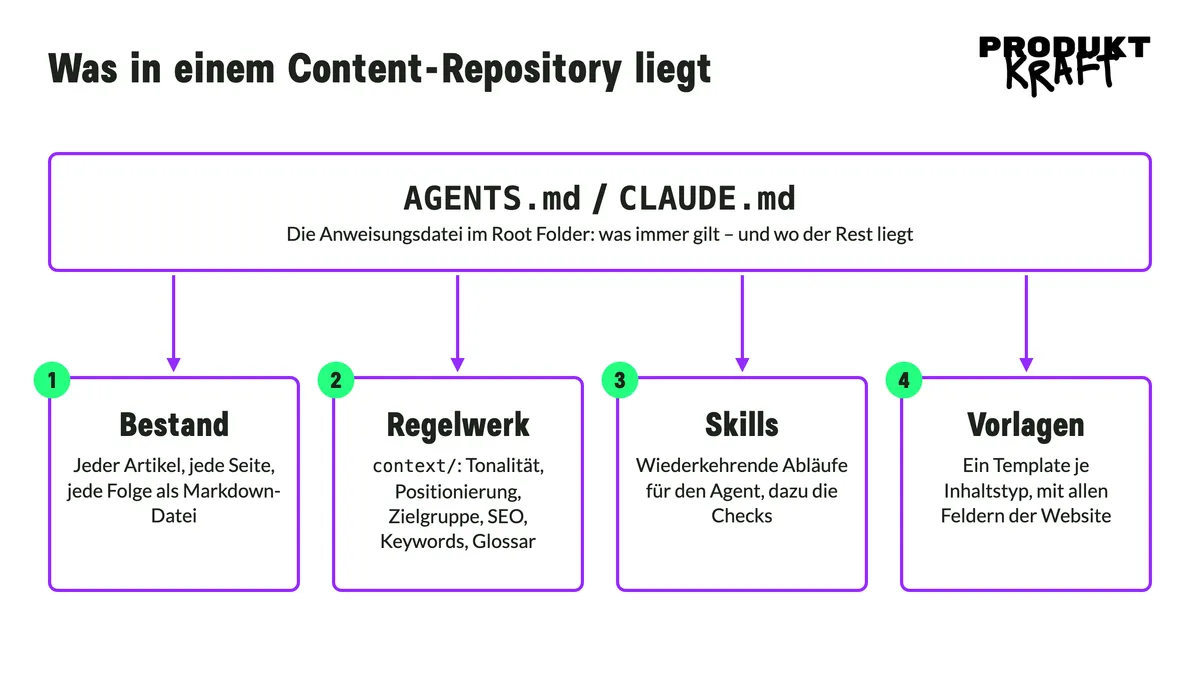
Wie so ein Repository aussieht, zeige ich Euch am Beispiel von produktkraft.com. Darin liegen vier Dinge:
- Der Bestand. Jeder Blogartikel, jede Seite, jede Podcastfolge als Markdown-Datei.
- Das Regelwerk. Ein Ordner
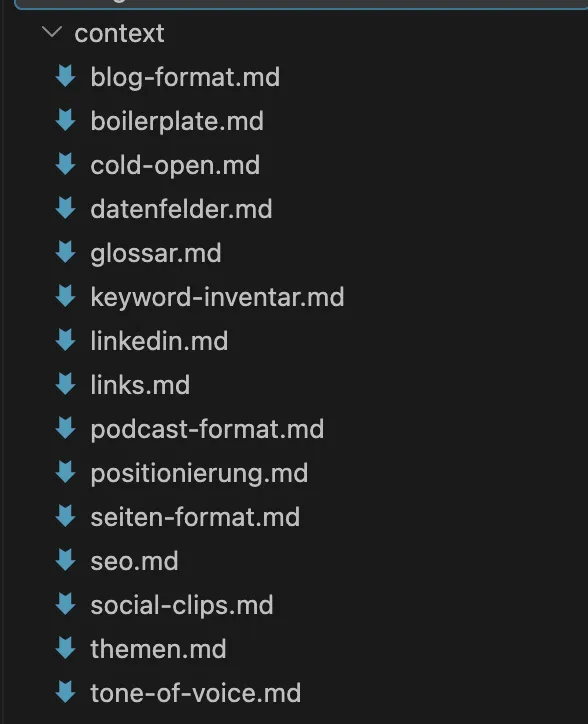
context/mit Dateien zu Tonalität, Positionierung, Zielgruppe, SEO, Keywords, Glossar, Linkregeln. Alles, was sonst in einem Brand-Guidelines-PDF steht, das niemand öffnet, oder im Kopf von zwei Menschen, die gerade Urlaub haben. - Die Skills. Wiederkehrende Abläufe als Anleitung für den Agent – bis hin zu einer kompletten Produktionsstrecke für den Podcast, für die man sonst ein halbes Dutzend Werkzeuge und viel Hin-und-her-Kopieren bräuchte. Dazu Prüfungen für Tonalität und SEO.
- Die Vorlagen. Ein Template je Inhaltstyp, mit allen Feldern, die die Website braucht.
Dazu kommt eine Anweisungsdatei im Root Folder, die der Agent zu Beginn jeder Sitzung liest. Darin steht nicht das Regelwerk selbst, sondern was immer gilt – bei mir etwa „Nichts erfinden“ oder „Prüfen und Ändern sind getrennt“ – und wo der Rest liegt. Als AGENTS.md ist sie inzwischen ein offenes Format, das laut eigener Seite von über 60.000 Open-Source-Projekten genutzt und von der Linux Foundation betreut wird. Claude Code liest dieselbe Sache als CLAUDE.md.
Die Website selbst liegt in einem zweiten Repository nebenan. Getrennt sind die beiden, weil Inhalt und Code unterschiedlich schnell laufen – eine neue Podcastfolge ist eine inhaltliche Änderung, kein Anlass, am Code der Website etwas anzufassen. Der zweite Grund ist Content Bleeding. Ein Agent, der im selben Repository Komponenten baut und Texte schreibt, hat beides gleichzeitig im Kontext: Regeln für Code und Regeln für Sprache, Dateinamen und Tonalität, Build-Fehler und Zielgruppen. Evals habe ich dafür keine. Aber es würde mich sehr wundern, wenn diese Mischung die Agents nicht verwirren würde – und getrennt arbeitet jeder Agent nur mit dem Kontext, den er für seine Aufgabe braucht. Wie der Inhalt trotzdem auf die Website kommt, steht weiter unten.
Eine Änderung, alle Seiten
Hier liegt die Pointe, die ich versprochen habe. In einem Baukasten ist eine Änderung, die viele Seiten betrifft, eine Klickstrecke: jede Seite öffnen, die Stelle suchen, ändern, speichern, hoffen, dass man keine vergessen hat.
Ich weiß aus erster Hand, wie sich das anfühlt. Als Schüler und Student hatte ich mehrere Jobs als Content Editor, und das ist ein Knochenjob: Seite um Seite dieselbe Änderung, Stunde um Stunde, und am Ende trotzdem die eine Stelle übersehen. Genau das hat mich angetrieben, als ich mit dem Content-Repository angefangen habe. Ich dachte mir: Das muss doch heute nicht mehr so sein, oder?! Also habe ich das Konzept mit den zwei Repositories ausprobiert – und es hat funktioniert.
In einem Content-Repository ist so eine Änderung ein Satz an den Agent – und das Ergebnis ist ein Commit, den Ihr Zeile für Zeile prüfen könnt, bevor er live geht.
Ein paar Beispiele aus meinem eigenen Repository:
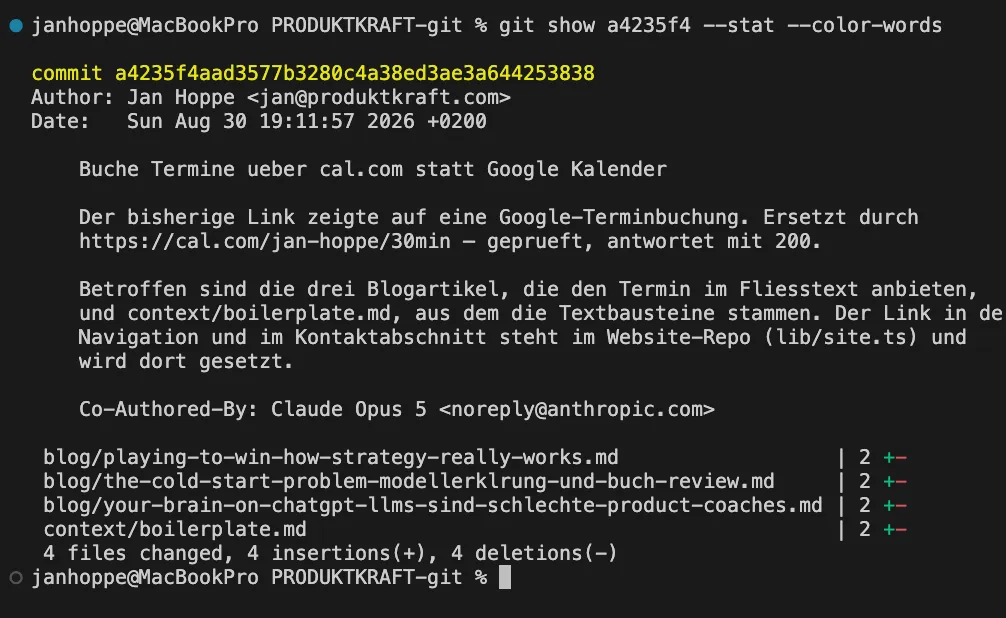
Ein Link zieht um. Meine Terminbuchung lief über Google Kalender und läuft jetzt über Cal.com. Der Agent hat die drei Blogartikel gefunden, die den Termin im Fließtext anbieten, und den Textbaustein, aus dem sie stammen, den neuen Link vorher auf Erreichbarkeit geprüft – und dazugeschrieben, dass der Link in der Navigation im Website-Repo steht und dort gesetzt werden muss. Vier Dateien, ein Commit, eine Notiz, wo der Rest liegt – statt ewig auf der Website herumzustochern und am Ende doch nicht sicher zu sein, ob man alle Stellen gefunden hat.
Ein Fehler, der überall steckt. Die Kapitelmarken meiner Podcastfolgen lagen im Median 43 Sekunden zu früh – in allen 21 Folgen, weil das Skript, das sie gesetzt hatte, an der falschen Stelle gesucht hat. Nach der Korrektur liegen 93 von 94 Marken auf drei Sekunden genau, gegengeprüft am Transkript der jeweiligen MP3. Im Baukasten hätte ich das nicht einmal bemerkt.
Ein Bestand, der zum Regelwerk passen soll. Als das Regelwerk stand, lief der alte Blog in einem Durchgang dagegen: 32 Stellen mit kleingeschriebener Anrede, 31 fehlende Alt-Texte, 19 fett formatierte Überschriften als Rest des alten Baukastens, vier zu lange Meta Descriptions. Genauso wichtig wie das, was geändert wurde, steht in der Commit-Nachricht, was bewusst nicht angefasst wurde: die verstümmelten URLs, weil eine geänderte URL jeden Link bricht.
Ein Widerspruch, den nur eine Maschine ernst nimmt. Auf meiner Startseite stand an einer Stelle „10+ Jahre“ Erfahrung, an einer anderen „12+“. Für einen Menschen ist das eine Unschärfe. Für ein Sprachmodell, das die Seite liest, ist es ein Grund, keiner der beiden Zahlen zu trauen – und genau diese Selbstbeschreibung wandert ins strukturierte Markup und in die llms.txt. Jetzt steht die gültige Zahl an einer Stelle im Regelwerk, und jeder Text, der sie braucht, holt sie von dort. Warum es so sehr darauf ankommt, von Sprachmodellen richtig gelesen zu werden, war Thema meiner Folge über AI-First-Gründungen mit Henrik Roth.
Das größere Beispiel kommt aus ganzheit, der Dokumentationsplattform für PsychotherapeutInnen, deren Website auf demselben Prinzip läuft. Stellt Euch vor, Ihr launcht ein Feature, das Fragen beantwortet, die überall auf Eurer Seite gestellt werden. Bei ganzheit war das die Möglichkeit, einen Auftragsverarbeitungsvertrag abzuschließen – ein Thema, das auf den Produktseiten steht, im FAQ, und in den Fragen am Ende vieler Blogartikel. Mit dem Launch hat der Agent sechs Seiten und neun Blog-FAQs in einem Zug angepasst – in fünf Minuten. Im Nachgang kamen noch einmal zehn Blogartikel dazu. Und weil die Änderungen an der Website dort als Pull Request gingen, ließen sie sich auf den Release des Features abstimmen – nicht vorher, nicht vergessen.
Wer einmal bei einem Feature-Launch die halbe Website nachgezogen hat, weiß, wie oft danach noch irgendwo die alte Formulierung steht.
Landing Pages aus dem, was schon da ist
Dieselbe Logik funktioniert auch in die andere Richtung: nicht bestehende Inhalte ändern, sondern aus ihnen neue bauen.
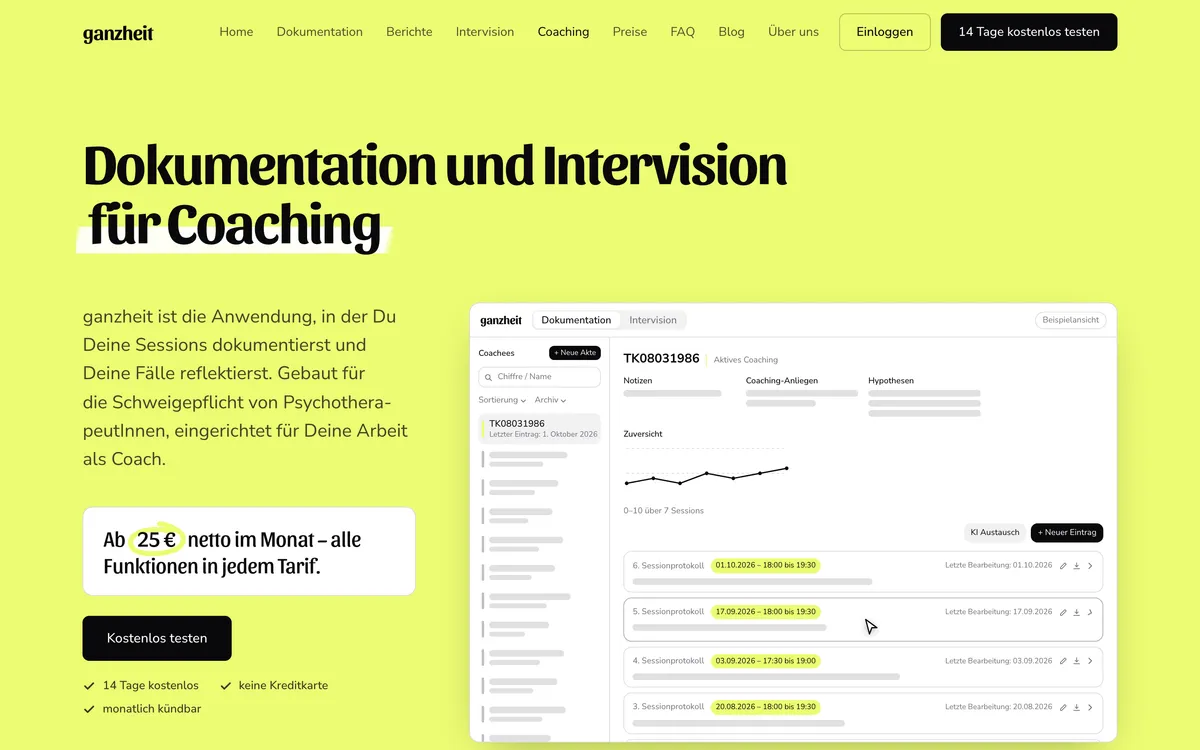
Bei ganzheit kam im Herbst eine neue Zielgruppe dazu: systemische Coaches, für die die App einen eigenen Coaching-Modus bekommen hat. Die brauchten einen eigenen Eingang auf der Website, aber keine zweite Positionierung. Also eine Landing Page – und das Material dafür lag zum größten Teil schon im Repository. Die Datenschutzsätze kamen wörtlich aus dem FAQ und den Compliance-Regeln, mit der ausdrücklichen Anweisung, sie nicht umzuformulieren. Die Kernaussage der Startseite wurde für die neue Zielgruppe übersetzt, und dafür gab es eine neue Regel im Zielgruppen-Dokument: Bei Coaches heißen die Menschen „Coachees“, nie „PatientInnen“, und therapeutisches Vokabular bleibt draußen. Die Preiszeile folgt dem Muster der Startseite, das Kundenzitat stammt aus der Datei mit den freigegebenen Testimonials.
Vom ersten Text-Commit bis zur gebauten, feingetunten Seite vergingen rund drei Stunden. Davon waren höchstens 30 Minuten aktive Arbeit – der Rest war Warten, Lesen, Freigeben. Und aus demselben Text entstehen inzwischen auch die A4-Unterlagen, die Coaches ihren Coachees mitgeben können.
Für eine Kampagne gilt dasselbe. Eine Kampagnen-Landingpage ist selten ein neuer Gedanke, sondern eine Zuspitzung: eine Zielgruppe, ein Einwand, ein Beweis. Den Einwand und den Beweis muss Euch niemand neu schreiben, die stehen in Euren Seiten, Euren Kundenstimmen, Euren FAQs. Was der Agent braucht, ist ein kurzer Brief – für wen, gegen welchen Einwand, mit welchem Beleg – und den Zugriff auf alles, was schon da ist. Was er nicht braucht, ist eine leere Seite.
Der Podcast ist der Inhalt, der Rest ist Fleißarbeit
Am deutlichsten wird der Unterschied beim Podcast – und hier ist er mir auch am liebsten. Denn der eigentliche Inhalt einer Folge ist das Gespräch. Das führe ich, das kann mir kein Agent abnehmen, und das soll er auch nicht. Alles drumherum ist Fleißarbeit: transkribieren, Kapitel setzen, Highlights für den Teaser heraussuchen, die Episodenseite schreiben, die Folge ankündigen. Heute startet all das ein Befehl, /podcast-episode, der die Teilschritte nacheinander aufruft und den Stand in einer Datei pro Folge festhält:
- Transkription. Der Rohschnitt wird lokal mit Whisper transkribiert, auf dem eigenen Rechner, ohne dass die Aufnahme irgendwohin hochgeladen wird – gemessen gut acht Minuten für 94 Minuten Audio. Whisper versteht deutsche Fließrede sehr gut, verhaut aber zuverlässig englische Fachbegriffe und Namen in deutscher Aussprache. Dafür gibt es ein Glossar im Regelwerk, das jede bekannte Fehlschreibung auf die richtige Form zieht.
- Glätten. Der Agent setzt Sprecher, entfernt Füllwörter und Versprecher und zieht Kapitelüberschriften ein – nach der Gliederung des Gesprächs, nicht gleichmäßig über die Laufzeit verteilt. Die Regel dafür steht ganz oben: geglättet, nicht gekürzt. Kein Inhalt fällt weg, keiner kommt dazu.
- Highlights für den Cold Open. Jede Folge beginnt mit einer Montage aus Aussagen des Gasts, bevor mein Intro einsetzt. Diese Stellen habe ich früher von Hand aus dem Gespräch gesucht. Jetzt markiert der Agent bei der Transkription zehn Kandidaten mit exakten Zeitstempeln im Rohschnitt, ich wähle vier bis sechs davon aus, und die Audio-Postproduktion schneidet daraus parallel die Montage.
- Episodenseite. Titel, Teaser, Text, SEO-Felder, Links, Kapitelmarken. Drei Titelvarianten, gewählt wird von mir. Die Zeiten der Kapitelmarken werden dabei an der fertigen MP3 gemessen, nicht aus dem Rohtranskript übernommen – die fertige Folge hat den Cold Open vorne dran, und bei Folge 23 lag dadurch alles 70 Sekunden später.
- LinkedIn-Post. Der Ankündigungspost mit Hook, Fachbegriffen und den festen Blöcken – auf LinkedIn sind sogar Emojis erlaubt, an festen Positionen, die auf der Website verboten sind.
- Social Clips, auf Zuruf. Einminüter, die ohne Kontext für sich stehen müssen. Weil sie aus der ungeschnittenen Aufnahme kommen, deren Zeitachse nicht zum Rohschnitt passt, liefert der Agent hier keine Zeitstempel, sondern den Zitattext, nach dem ich im Schnittwerkzeug suche.
Und dann geht es in die Veröffentlichung, wieder ohne dass ich irgendwo etwas hin und her kopiere: Der Agent schreibt die Datei, die die Website liest, legt die Folge im Website-Repo an, bringt Cover und Banner in die richtigen Formate und lädt die MP3 nach R2 – mit einer Prüfung vorher und nachher, ob dort auch genau die Datei liegt, deren Größe im Feed steht. Zwei Handgriffe bleiben bewusst bei mir: das Okay für den Upload und der Push, denn der ist live.
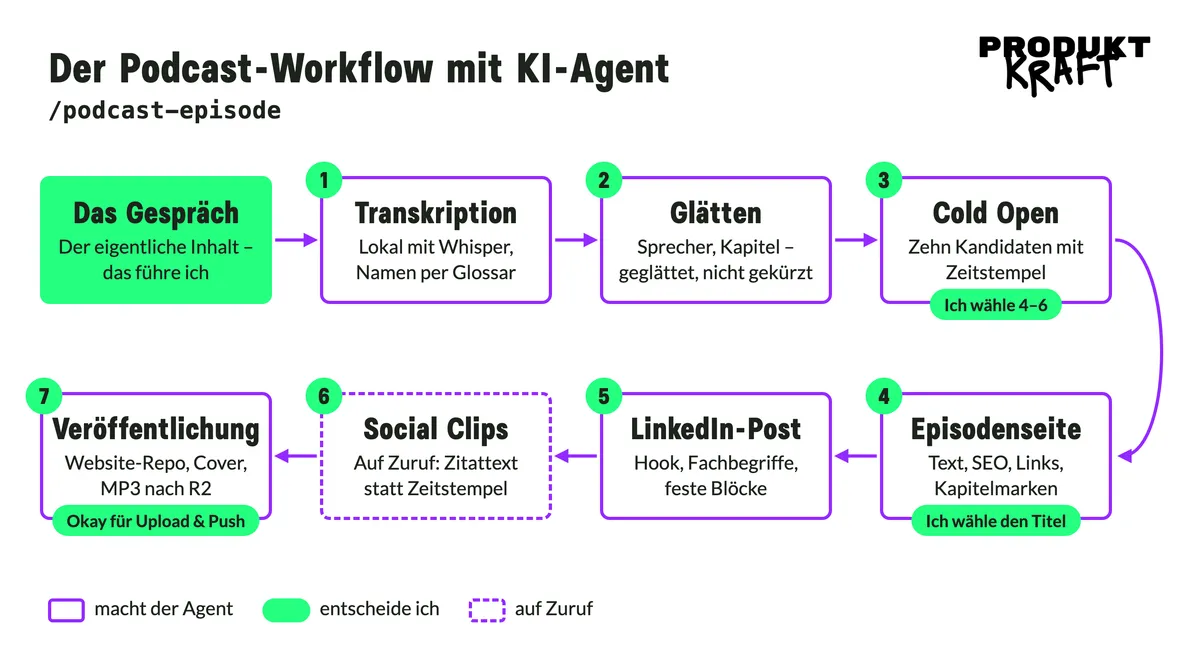
Was früher Transkriptionsdienst, Schnittnotizen, Texteditor, CMS, Upload-Formular und LinkedIn-Entwurf war, ist heute im Kern ein „Mach mal“ – und ich lese, wähle und gebe frei.
Keiner dieser Schritte ist für sich besonders schwer. Aber jeder steckt voller Details, die man beim dritten Mal vergessen hat – und genau die stehen jetzt im Repository statt in meinem Kopf.
Das ist mehr wert, als es klingt. Wer wie ich freiberuflich für mehrere Kunden arbeitet und gleichzeitig ein Startup gründet – was ein bisschen verrückt ist, aber klappt 🙃 –, weiß, wie genau man den eigenen Mental Load im Blick behalten muss. Jedes Detail, das nicht mehr in meinem Kopf liegen muss, ist Platz für ein anderes Thema, das gerade wichtiger oder dringender ist.
Am LinkedIn-Post sieht man, wie das Repository lernt. Der Post zu Folge 23 erschien am Ende nicht so, wie der Agent ihn geschrieben hatte: In der ersten Zeile fehlten die früheren Stationen des Gasts, und statt einer Linkliste standen die Plattformen als Text da. Also wurde die tatsächlich veröffentlichte Fassung zurück ins Repository geschrieben. Der nächste Post entsteht damit nicht aus dem Entwurf, sondern aus dem, was wirklich erschienen ist.
Genauso wandern Fehler in die Regeln. Beim ersten Durchlauf hat die Webrecherche zum Gast eine falsche Rollenbezeichnung geliefert und Firmen, die Beratungskunden waren, keine früheren Arbeitgeber – beinahe wären sie als „ex“-Stationen im Titel gelandet. Seitdem steht im Skill: Jeder Gast stellt sich in den ersten Minuten selbst vor, und diese Selbstvorstellung hat Vorrang vor jeder Recherche. Jeder Fehler, den der Agent zweimal macht, wird eine Regel.
Tonalität, die nicht im PDF verstaubt
Jedes Unternehmen ab einer gewissen Größe hat Brand Guidelines. Die meisten liegen als PDF in einem Ordner, wurden einmal vorgestellt und seitdem nur noch beim Onboarding verschickt. Kaum ein Text wird tatsächlich gegen sie geprüft, weil das niemand leisten kann.
Im Content-Repository liegen sie als Datei, und der Agent liest sie bei jedem Text. Bei mir heißt sie tone-of-voice.md, und sie enthält keine Adjektive wie „nahbar, kompetent, frisch“, sondern Regeln mit Belegen: welche Wörter ich verwende und welche nie, wie ich Sätze baue, welche Einstiege funktionieren – jeweils mit echten Sätzen aus veröffentlichten Texten. Die meistgebrochene Regel steht ganz oben: Ob ich „Du“, „Ihr“ oder „wir“ schreibe, folgt dem Adressaten, nicht dem Kanal. Jeder Text hält in seinem Kopf fest, welche Form für ihn gilt.
Zwei Prinzipien haben sich dabei als wichtiger erwiesen als jede einzelne Regel.
Der Bestand ist der Maßstab, nicht die Regel. Wenn eine Prüfung einen veröffentlichten Text bemängelt, der gut funktioniert, ist nicht der Text falsch, sondern die Regel falsch kalibriert. Regelwerke, die aus Wunschvorstellungen statt aus dem eigenen besten Material abgeleitet werden, produzieren Texte, die nach Regelwerk klingen.
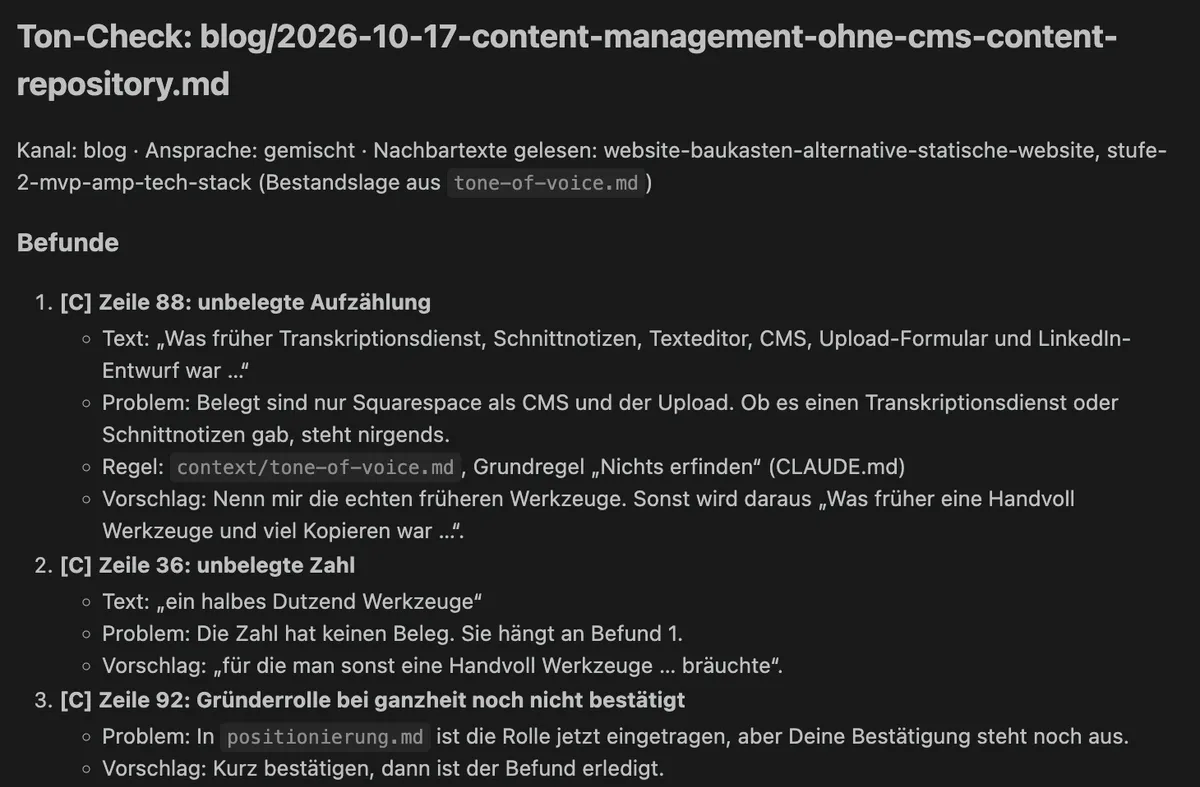
Prüfen und Ändern sind getrennt. Der Skill ton-check meldet nur – mit Fundstelle und verletzter Regel – und ändert nie eine Datei. Ändern darf nur text-redigieren, und der fragt vorher, wie tief er eingreifen soll: Korrektur, Straffung oder Überarbeitung. Jede Korrektur bleibt eine Entscheidung. Ein Agent, der still „verbessert“, schleift Eure Stimme in ein paar Wochen auf den Durchschnitt herunter.
So sieht das in der Praxis aus – hier der Ton-Check über den Entwurf dieses Artikels beim Redigieren. Er meldet unter anderem eine Aufzählung, für die er im Repository keinen Beleg findet. Die Aufzählung stimmt trotzdem, also bleibt sie stehen. Der Check hat gemeldet, entschieden habe ich.
Und die Tonalität bleibt nicht stehen. Der wichtigste Schritt dafür ist überraschend simpel: Am Ende einer langen Session frage ich den Agent, was wir gelernt haben, das wir im Kontext festhalten sollten. Welche Formulierung habe ich dreimal zurückgewiesen? Welche Regel hat nicht gegriffen? Was habe ich entschieden, das nirgends steht? Daraus wird eine Änderung am Regelwerk – als Pull Request, nicht als Meeting. Ich lese den Diff, nehme an, was stimmt, und verwerfe den Rest. So wächst die Tonalität mit jedem Text ein Stück, statt einmal im Jahr in einem Workshop neu verhandelt zu werden.
SEO und Zielgruppe als Prüfung, nicht als Bauchgefühl
Dasselbe gilt für SEO. Im Baukasten gibt es ein Plugin, das eine Ampel zeigt. Im Content-Repository gibt es eine Datei mit Regeln und einen Skill, der dagegen prüft: Steht das Primärkeyword vorn im Titel? Hat die Meta Description 140 bis 160 Zeichen – gemessen, nicht geschätzt? Ist der Slug sprechend? Verlinkt der Text auf mindestens einen eigenen verwandten Inhalt?
Der eigentliche Gewinn liegt aber in einer Datei, die kein Plugin kennt: dem Keyword-Inventar. Darin steht, welches Primärkeyword an welchen Inhalt vergeben ist. Zwei Seiten, die auf denselben Suchbegriff zielen, nehmen sich gegenseitig die Position – und das passiert schneller, als man denkt. In meinem eigenen Podcast-Bestand zielen vier Folgen auf „KI im Produktmanagement“. Das ist nicht mehr zu reparieren, ohne URLs zu brechen. Aber es passiert kein fünftes Mal, weil jeder neue Text sein Keyword jetzt aus dem Inventar bekommt, bevor die Recherche beginnt.
Für die Zielgruppe funktioniert es genauso. Bei mir steht in der Positionierung, für wen ich schreibe und was über mein Angebot gesagt werden darf. Bei ganzheit gibt es einen eigenen Check, der Texte gegen die Zielgruppen prüft – und bei der Coaching-Seite waren zwei seiner Durchgänge gegenstandslos, weil sie auf PsychotherapeutInnen geschrieben sind. Auch das ist ein Befund: Eine neue Zielgruppe ist nicht nur eine neue Seite, sondern eine neue Regel.
Content-Sync: Wie der Inhalt auf die Website kommt
Bleibt die Frage, wie der Inhalt aus dem einen Repository in das andere kommt. Bei produktkraft.com macht das ein Befehl im Website-Repo, pnpm content:sync. Er kopiert genau das, was auf die Seite gehört: Blogartikel, Seiten, und von jeder Podcastfolge zwei Dateien. Arbeitsdokumente wie die Titelvarianten mit ihren Begründungen bleiben bewusst draußen. Dazu schreibt der Sync eine kleine Datei, die festhält, aus welchem Commit des Content-Repositorys die Kopie stammt. Jeder Build lässt sich damit einem Stand der Inhalte zuordnen.
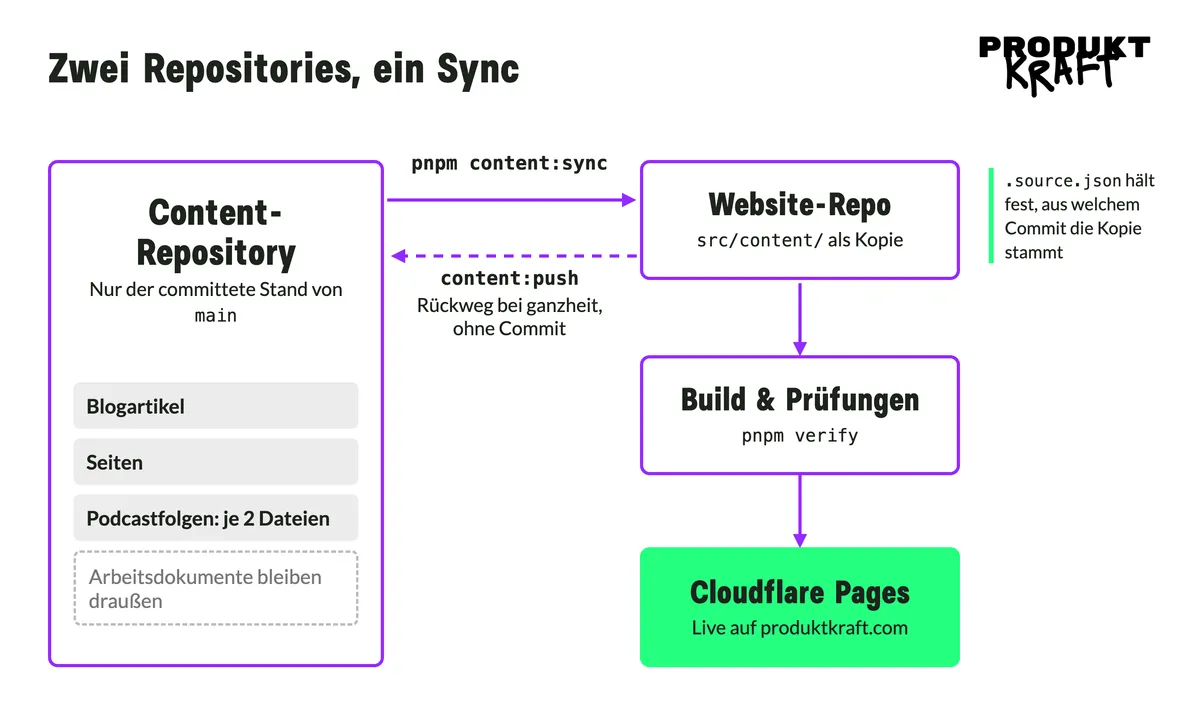
Klingt nach Detail, ist aber keines. Bei ganzheit hat ein Sync einmal einen Entwurf der Startseite mitgenommen, der im Content-Repository nur als lokale, noch nicht committete Arbeit lag. Die Website-Vorlage fand den Abschnitt nicht mehr, den sie erwartete, und der Build brach ab. Seitdem gilt eine Regel ohne Ausnahme: Auf die Website kommt nur, was im Content-Repository auf main steht. Ein Entwurf ist Arbeit im Gang, kein Stand.
Bei ganzheit gibt es zusätzlich den Rückweg. Beim Feintuning auf der Website entsteht laufend Textbedarf – eine Headline umbrechen, einen Button kürzen. Das zu verbieten wäre unpraktisch. Also darf der Text auf der Website geändert werden, eine Prüfung meldet die Abweichung, und ein zweiter Befehl schreibt die Änderung ins Content-Repository zurück, ohne sie dort zu committen. Die Redaktion prüft und entscheidet. Die Regel dahinter lässt sich auf fast jede Organisation übertragen: Abweichungen dürfen entstehen, sie müssen nur sichtbar sein und einen Weg zurück haben.
Das Repository als Gehirn
Wenn ich alles Bisherige auf einen Satz bringen müsste, dann diesen: Das Content-Repository ist der eine Ort, der den inhaltlichen Kontext aller Bereiche kennt.
Darin liegen die Positionierung, das Angebot, die Zielgruppen, die Keywords, das Glossar, die Tonalität – und der gesamte Bestand. Deshalb kann eine Episodenseite auf den Artikel verweisen, der das Thema vertieft, weil der Agent sie im selben Repository findet. Deshalb trifft ein LinkedIn-Post den Ton der Website. Deshalb übernimmt eine Landing Page den Datenschutzsatz wörtlich, statt ihn ein drittes Mal leicht anders zu formulieren.
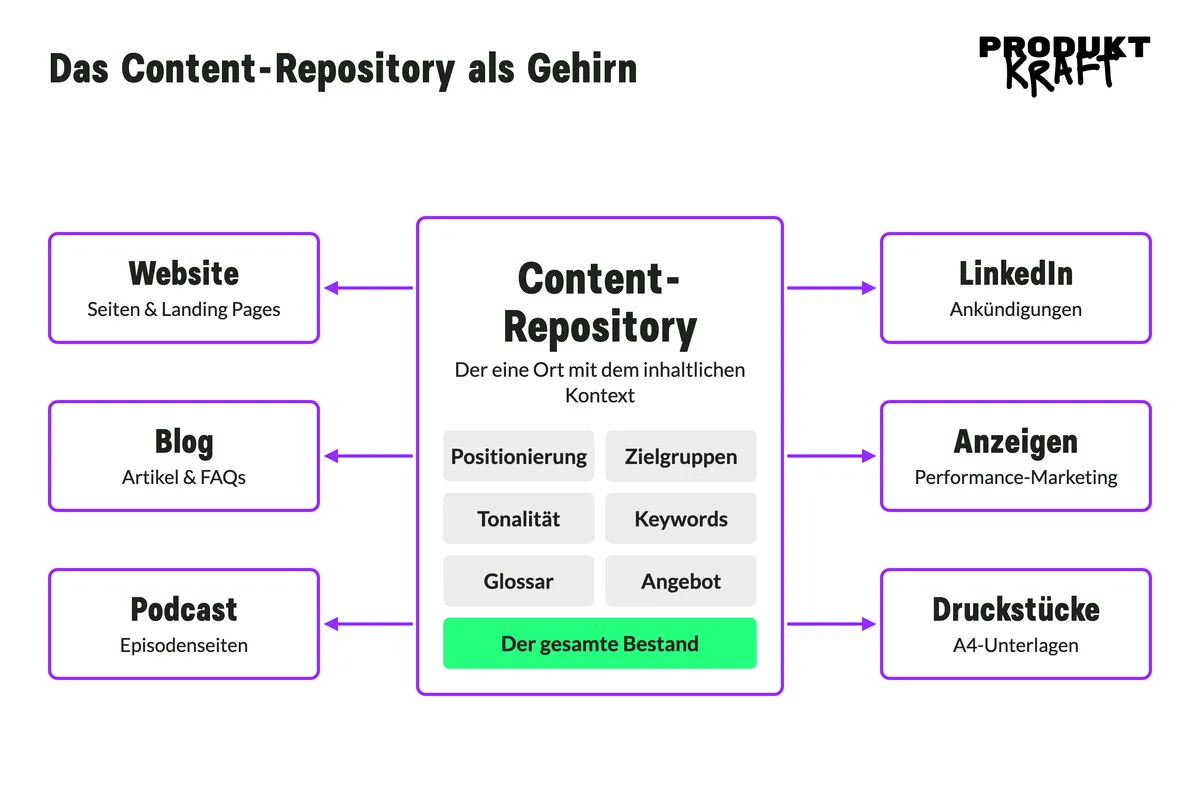
Bei ganzheit geht das inzwischen über Website und Blog hinaus. Auch das Performance-Marketing hat ein eigenes Repository, und es holt sich Preise, Terminologie, Positionierung und die Compliance-Regeln per Sync aus dem Content-Repository. Eine Anzeige kann damit nicht mehr versprechen, was die Website längst nicht mehr sagt. Vielleicht gibt es dazu bald einen eigenen Artikel – schreibt mir gern, wenn Euch das interessiert.
Und das Gehirn hat ein Gedächtnis. Jede Änderung ist ein Commit, und jede Commit-Nachricht kann erklären, warum ein Text so ist, wie er ist. Warum steht auf der Startseite „12+“? Warum ist diese URL verstümmelt und bleibt es trotzdem? Warum steht im LinkedIn-Post diese eine Zeile nicht? Die Antwort steht in der Historie, nicht im Kopf einer Person, die das Unternehmen vor zwei Jahren verlassen hat. Und wenn eine Änderung falsch war, geht sie mit einem Befehl zurück, statt rekonstruiert zu werden.
Ein bisschen Git muss sein – aber weniger, als Ihr denkt
Jetzt der Einwand, den jeder Vergleich von Git-basierten und klassischen CMS bringt: Für nicht-technische RedakteurInnen ist ein Git-Workflow eine Hürde, und Freigabeketten, Rollen und Vorschau fehlen. Das stimmt, und ich will es nicht kleinreden. Wer in einem Marketingteam mit einem Content-Repository arbeiten soll, muss ein wenig Git lernen – was ein Commit ist, was ein Branch ist, warum man nicht direkt auf main schreibt.
Aber der Einstieg ist niedriger, als er klingt. Eine Markdown-Datei lässt sich direkt im Browser bearbeiten, auf GitHub wie auf GitLab: Datei öffnen, Stift-Symbol, Text ändern, Vorschau ansehen, „Propose changes“. Daraus wird ein Pull Request oder Merge Request, und genau das ist die Freigabekette, die angeblich fehlt. Jemand sieht die Änderung, kommentiert, gibt frei. Die Prüfungen laufen automatisch mit. Und was die visuelle Oberfläche angeht: Die ersetzt der Agent, dem Ihr in normaler Sprache sagt, was Ihr wollt. Wer trotzdem lieber klickt, findet mit Git-basierten Editoren wie Decap CMS oder TinaCMS einen Mittelweg.
Das Beste daran ist aber etwas anderes: Die Datei ist zugleich das Briefing. Oben im Kopf jeder Datei steht nicht nur, was die Website braucht – Titel, URL, Meta Description –, sondern auch, wie der Inhalt umgesetzt werden soll: für welche Zielgruppe, auf welches Keyword, in welcher Ansprache, in welchem Status, mit welchem Auftrag. Bei der Coaching-Seite von ganzheit stehen unter dem Text sogar eigene „Hinweise zur Umsetzung“, mit Begründungen und den offenen Punkten, bevor die Seite final werden darf.
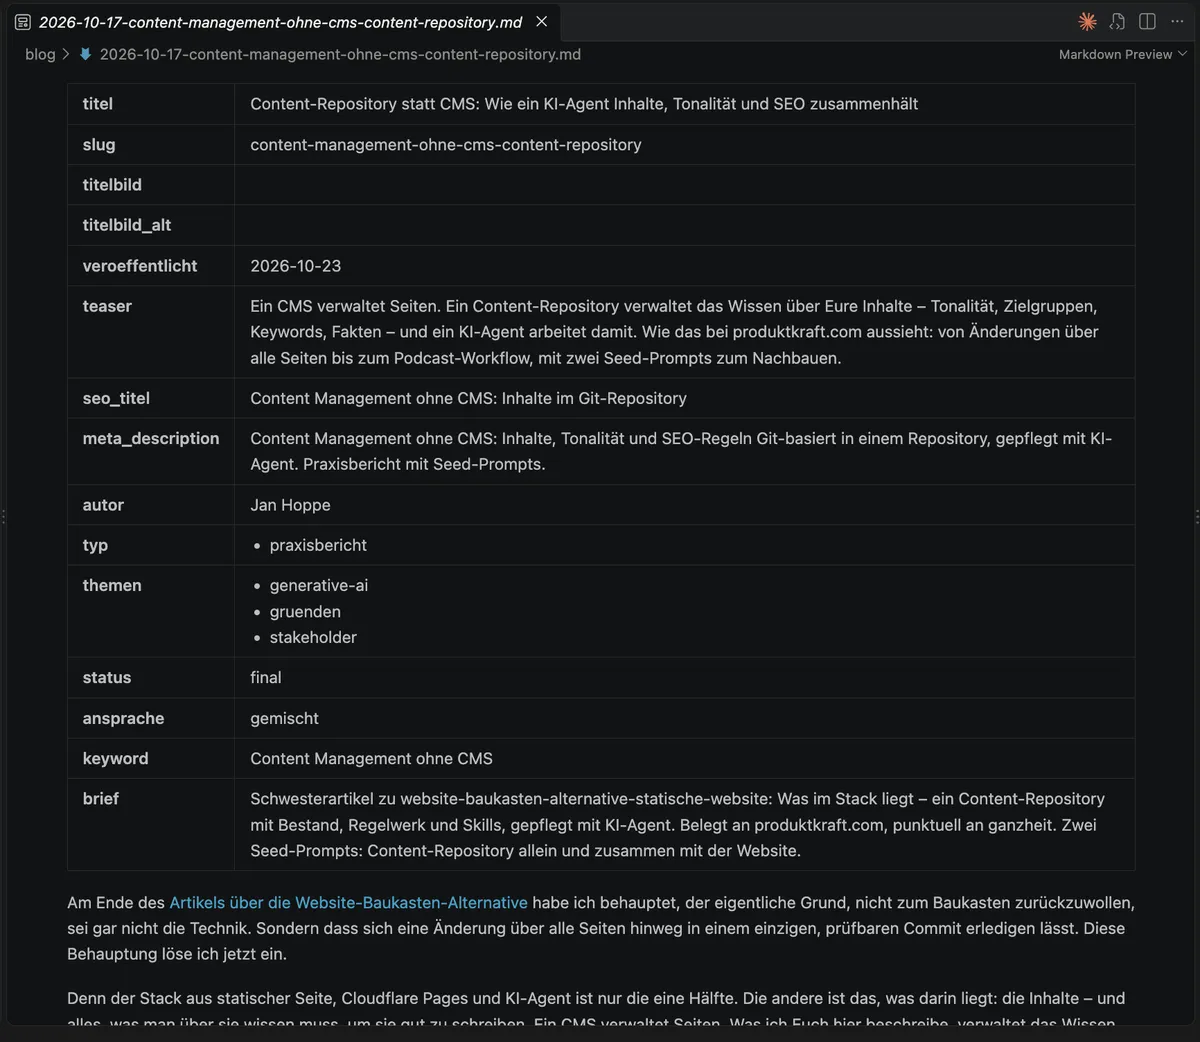
Das kennen Marketeers. Es ist genau das, was sie seit Jahren für ihre Agenturen schreiben: ein Briefing mit Zielgruppe, Tonalität, Kernaussage und Do's and Don'ts. Nur liest es jetzt ein Agent, der in Minuten statt in Abstimmungsschleifen antwortet – und Briefing und Ergebnis liegen in derselben Datei, versioniert, für alle sichtbar. Kein Briefing geht mehr verloren, weil es in einer Mail stand.
Ein Seed zum Nachbauen
Wie fangt Ihr an? Wie im ersten Artikel gibt es zwei Wege: das Content-Repository für sich allein, auch wenn die Website (noch) im Baukasten bleibt, und Content-Repository und Website zusammen. Beide sind allgemein gehalten, nicht meine echten Dateien.
Gemeinsam ist beiden die Anweisung für den Agent im Root Folder des Content-Repositorys:
# Content-Repository der Beispiel GmbH

Alle veröffentlichten Inhalte und das Regelwerk dazu.

## Ordner
- `content/`    Seiten, Blogartikel, Landing Pages – je eine Markdown-Datei
- `context/`    tonalitaet.md, positionierung.md, zielgruppen.md,
                keyword-inventar.md, glossar.md
- `templates/`  eine Vorlage je Inhaltstyp
- `skills/`     wiederkehrende Abläufe (Landing Page, Ankündigung, Checks)

## Regeln
- Nichts erfinden. Aussagen über die Firma nur, wenn sie in
  positionierung.md belegt sind. Beispiele sind erlaubt, wenn sie
  als Beispiel erkennbar sind.
- Der Bestand ist der Maßstab: Widerspricht eine Regel einem
  veröffentlichten Text, der funktioniert, wird die Regel angepasst.
- Jeder Text hat im Frontmatter: titel, slug, seo_titel,
  meta_description, zielgruppe, keyword, ansprache, status, brief.
- Das Primärkeyword kommt aus keyword-inventar.md und wird dort
  vergeben, bevor geschrieben wird.
- Slugs veröffentlichter Seiten werden nie geändert.
- Checks melden nur. Geändert wird erst nach Rückfrage.
- Jeder Fehler, der zweimal passiert, wird eine Regel in dieser Datei.
Nur Content-Repository
Der Weg für alle, deren Website im Baukasten bleibt – vorerst oder für immer. Auch dann lohnt sich das Repository: Die Texte werden dort geschrieben und geprüft und danach in den Baukasten eingefügt. So lief es bei mir bis Ende August. Der erste Prompt könnte so aussehen:
Wir legen ein Content-Repository für <FIRMA> an. Die Website liegt
unter <https://www.eure-domain.de> und bleibt vorerst in <BAUKASTEN>.

Stehen in diesem Prompt noch Platzhalter in spitzen Klammern, frag
nach, bevor Du anfängst. Arbeite in dieser Reihenfolge und halte
nach jedem Schritt an, damit ich prüfen kann:

1. Bestand holen: Lies die Sitemap und übernimm jede Seite und jeden
   Artikel als Markdown nach content/, mit Frontmatter. Kein Wort
   umformulieren.
2. Regelwerk aus dem Bestand ableiten, nicht erfinden:
   - tonalitaet.md: wiederkehrende Muster mit echten Sätzen als Beleg,
     dazu die Wörter, die nie vorkommen.
   - positionierung.md: was über Angebot, Kunden und Erfahrung
     tatsächlich auf der Seite steht. Widersprüche als Liste an mich.
   - zielgruppen.md: wen die Seiten ansprechen, mit Fundstelle.
   - keyword-inventar.md: welche Seite auf welchen Suchbegriff zielt.
     Doppelt vergebene Begriffe als Liste an mich.
   Hier sind unsere Brand Guidelines: <PFAD ODER LINK>. Wo sie dem
   Bestand widersprechen, frag nach, statt Dich für eine Seite zu
   entscheiden.
3. Skills anlegen: ton-check und seo-check, die nur melden – mit
   Fundstelle, verletzter Regel und gemessenen Zeichenzahlen.
   Dazu einen Skill für Landing Pages, der mit einem Brief beginnt:
   Zielgruppe, Einwand, Beleg, Keyword.
4. Erster Durchgang: Lass beide Checks über den ganzen Bestand laufen
   und leg mir die Befunde als Liste vor, gruppiert nach Regel.
   Nichts ändern. Ich entscheide, was wir in einem Commit nachziehen.
Der vierte Schritt ist der wichtigste. Die erste Befundliste sagt Euch mehr über Eure Inhalte als jedes Content-Audit, und die Hälfte der Befunde wird zeigen, dass die Regel falsch ist, nicht der Text.
Content-Repository und Website
Der Weg, den ich gegangen bin: zwei Repositories nebeneinander, eines für die Inhalte, eines für die Website. Für die Website selbst gilt der Seed aus dem Artikel über die Website-Baukasten-Alternative. Dieser Prompt kommt dazu, sobald beide stehen:
Die Website in <WEBSITE-REPO> liest ihre Inhalte aus dem
Content-Repository in <../CONTENT-REPO>. Bau dafür einen Sync:

1. pnpm content:sync kopiert nach src/content/ – aber nur, was auf die
   Seite gehört: <content/seiten, content/blog, …>. Arbeitsdokumente
   bleiben draußen. Die Liste steht als Positivliste im Skript.
2. Herkunftsnachweis: Schreib bei jedem Sync src/content/.source.json
   mit dem Commit des Content-Repositorys und ob es sauber war.
3. Nur committeter Stand von main. Liegt im Content-Repository
   unversionierte Arbeit oder ein anderer Branch, brich ab und sag mir,
   was Du gefunden hast.
4. In src/content/ wird nie direkt geschrieben, sondern im
   Content-Repository. Optional: pnpm content:push schreibt Änderungen,
   die beim Feintuning hier entstehen, dorthin zurück – ohne zu
   committen. Vorher pnpm content:diff zeigen.
5. Eine Prüfung in pnpm verify warnt, wenn Kopie und Quelle
   auseinanderlaufen, mit Dateiliste in beide Richtungen.
6. Das Frontmatter-Schema der Website prüft alle Pflichtfelder.
   Fehlt eins, bricht der Build ab, nicht erst die Seite.
Danach ist jede inhaltliche Änderung ein Commit im Content-Repository, ein Sync und ein Build. Und jede Seite auf der Website lässt sich auf genau den Stand der Inhalte zurückführen, aus dem sie gebaut wurde.
Public Service Announcement: Das Regelwerk schreibt sich nicht selbst
Bei aller Begeisterung, auch hier der unbequeme Teil.
Ein Content-Repository ist so gut wie das Regelwerk darin, und das pflegt sich nicht selbst. Jede Regel in meinem context/-Ordner ist entstanden, weil etwas schiefgegangen ist oder weil ich eine Entscheidung getroffen habe. Der Agent hat sie aufgeschrieben, aber getroffen habe ich sie. Wer ein Repository mit Regeln füllt, die niemand entschieden hat, bekommt einen Agent, der sehr konsequent das Falsche tut.
Dasselbe gilt für das, was ich im ersten Artikel über Geschmack geschrieben habe: Das Regelwerk ersetzt keine Haltung. Eine Tonalitätsdatei, die aus „professionell, aber nahbar“ besteht, liefert Texte, die professionell, aber nahbar klingen – also wie alle. Eine Marke ist die Abweichung vom Durchschnitt, und die muss jemand formulieren, bevor ein Agent sie halten kann.
Ich will auch ehrlich sein, warum das bei mir funktioniert. Ich konnte dieses Setup nur so entwickeln, weil ich seit 1998 in diesem Feld unterwegs bin und ziemlich genau weiß, was ich will. Die Jobs als Content Editor, die Websites, die ich gebaut habe, die phpBB-Foren, die ich gehostet habe, meine Zeit als CPO bei Evernest, in der ich auch das Performance Marketing geführt habe, die enge Zusammenarbeit mit dem Marketing bei EventInc – mehr dazu in meiner Folge mit Carsten Bohling über Distribution und Marketing – und die Arbeit für Kunden – all das steckt in diesem Regelwerk, kondensiert auf ein paar Dateien. Das geht nicht, wenn man einfach die KI anschmeißt und sagt: „Mach mal was.“ Dann bekommt Ihr genau das – irgendwas. Damit es funktioniert, braucht es einen roten Faden und einen Nordstern: eine Vorstellung davon, wofür Eure Inhalte da sind und woran Ihr erkennt, dass sie gut sind.
Und manche Entscheidungen gehören gar nicht in ein Regelwerk. Der Agent erfindet keine Zitate, keine Zahlen und keine Kunden – das steht als erste Regel in der Anweisungsdatei, und die steht dort nicht zufällig ganz oben. Impressum und Datenschutzerklärung sind keine redaktionellen Texte und werden von keinem Check gestrafft. Ein Content-Repository macht Euch nicht die Arbeit an den Inhalten ab. Es sorgt dafür, dass jede Entscheidung, die Ihr einmal getroffen habt, auch beim nächsten Text noch gilt.
Wie Ihr anfangt
Wer bis hierher gelesen hat, braucht nicht gleich beide Repositories. Fangt mit dem ersten Reiter an: den Bestand holen, die Regeln aus dem besten eigenen Material ableiten, einmal die Checks drüberlaufen lassen. Die Befundliste ist der Moment, in dem sich entscheidet, ob Ihr das wollt.
Viele Teams sind an dieser Stelle überrascht, wie ihre Marke tatsächlich dasteht – denn die Regeln, die aus dem Bestand abgeleitet werden, beschreiben die Marke, die Ihr veröffentlicht habt, nicht die, die Ihr im Kopf habt. Daraus entstehen einige der wertvollsten Diskussionen, die ein Team führen kann: Braucht die Marke ein Update – oder nur die Art, wie sie auf Eurer Seite repräsentiert ist?
Und wenn Ihr den roten Faden oder den Nordstern noch sucht: Meldet Euch bei mir. Ich helfe gern – beim Aufsetzen, beim Regelwerk und bei der Frage, wie das in Eure Organisation passt –, damit Euer KI-Einsatz nicht in Slop endet. Kennenlern-Termin buchen.